🇺🇸 Also available in English: Invisible Coupling: When Your Microservices Become a Distributed Monolith
Pico de Black Friday. O checkout tem microsserviços, pipeline CI/CD, container, função serverless, cada peça com deploy próprio e dashboard verde. Aí o serviço de liquidação, lá no fim da cadeia, começa a demorar para responder, e em poucos minutos a autorização de pagamento inteira está dando timeout. No papel, cada serviço era independente, e mesmo assim o cliente desistiu da compra esperando a aprovação.
Essa cena tem nome, acoplamento invisível, e o sistema que ela produz também: um monolito distribuído. Se isso te soa familiar, vem comigo que esse post é para você. Ele abre uma série sobre o tema: nos próximos posts eu mostro como quebrar essas dependências separando o hot path dos side-effects, passo pelos patterns que sustentam essa quebra, e fecho com a mão na massa num protótipo na AWS.
Acoplamento invisível, o que é de verdade
Acoplamento é a medida de quanto um serviço depende de outro para funcionar. E a provocação que eu quero deixar logo aqui: se o seu microsserviço só responde porque outro respondeu antes, essa independência é ilusão. Na prática, ele é parte de um monolito distribuído.
O Sam Newman explora esse termo, monolito distribuído, no Monolith to Microservices, e ele descreve exatamente a armadilha: você pagou todo o preço de operar serviços separados (rede, deploy, observabilidade, tracing) e não levou o prêmio, que era a independência. O perigo é a falsa sensação de modernidade. Tem todo o aparato de microsserviços ali, mas se um ponto falha, o sistema falha junto. Distribuir não apagou o acoplamento, só deixou ele mais difícil de enxergar.
O comentário que me fez escrever isto
Dias atrás eu li, numa discussão sobre serverless, um argumento mais ou menos assim:
“Em ambientes complexos, quando microsserviços dependem de outros, e esses de terceiros, a latência dessas requisições aumenta muito o custo e pode tornar o modelo inviável. Além disso, em cenários que exigem muito processamento, serverless também pode não ser a melhor opção por conta do custo.”
Esse argumento aparece o tempo todo, e ele toca num ponto real: cadeias de dependência entre microsserviços são caras, frágeis e lentas. Até aí, concordo.
Só que isso não é um problema de serverless. É um problema de arquitetura. Rodando em AWS Lambda, ECS, EKS ou numa VM na sua sala, se a integração for mal desenhada o resultado é o mesmo: latência, custo e fragilidade. A cadeia síncrona não fica mais rápida porque você trocou o runtime embaixo dela.
Por isso a discussão “serverless vs. containers” me parece briga pelo prato errado. Tem cenário para cada um (workload stateful e job longo pedem container; event-driven e escala intermitente brilham em serverless), mas esse catálogo fica para outro dia.
O ponto central deste post é este:
A independência de um microsserviço se decide na forma como você desenha a integração dele, e o runtime não tem voto nessa mesa.
Acoplamento temporal e latência acumulada
O acoplamento temporal acontece quando um serviço só consegue responder se outro estiver de pé naquele exato instante. A disponibilidade e a latência de um serviço passam a contaminar todos os outros da cadeia.
E vem o efeito cascata. Cada hop síncrono adiciona alguns milissegundos, o que parece bobagem no começo. Aí você soma cinco chamadas em série e a latência explode justamente nos percentis de cauda, naquelas requisições mais lentas que são 5% ou 1% do total. É ali que se decide se o cliente finaliza a compra ou abandona o carrinho.
Bora fazer uma conta de padaria, com números ilustrativos e hipotéticos, só para visualizar. Cinco serviços em série, cada um respondendo em 40ms na mediana: a cadeia inteira fica na casa dos 200ms. Até aí, vida que segue. Só que requisição real não vive na mediana. Se cada hop tem 1% de chance de engasgar e levar 2 segundos, numa cadeia de cinco a chance de pelo menos um engasgar chega perto de 5%. Uma em cada vinte transações vai sentir. E o cliente que sentiu não quer saber que a SUA média está linda. É a mesma aritmética de componentes em série que derruba a disponibilidade no post sobre por que multi-cloud pode te deixar menos resiliente: cada elo a mais multiplica a chance de algo dar errado.
O monolito distribuído em ação: pagamentos
Volto ao pagamento da abertura porque ali cada milissegundo conta. O cliente está na fila do caixa esperando a aprovação, ou o e-commerce precisa confirmar antes que ele desista. Um atraso de poucos segundos custa receita e confiança.
E a conta não fica só com o lojista: a bandeira também cobra. As Transaction Processing Rules da Mastercard (seções 2.3 e 2.4) exigem que o banco emissor responda à autorização dentro de um tempo máximo, e se a resposta não chegar a tempo a transação dá timeout e cai no Stand-In Processing. Para transações Maestro e de ATM, um emissor com mais de 2% de falhas por indisponibilidade, mau funcionamento ou timeout em dois meses seguidos já está abaixo do padrão, e quem descumpre os padrões de desempenho fica sujeito a multa de US$ 15 mil na primeira ocorrência, chegando a US$ 20 mil a partir da terceira dentro de 12 meses. No pagamento, latência faz parte do contrato.
No modelo síncrono tradicional, uma autorização desce essa escada: o serviço de Autorização chama o de Fraude, que chama o de Limites, que chama o de Liquidação. A resposta só sobe de volta para o cliente quando o último responde. Repara no desenho linear do diagrama abaixo: ninguém anda sem o de baixo responder.
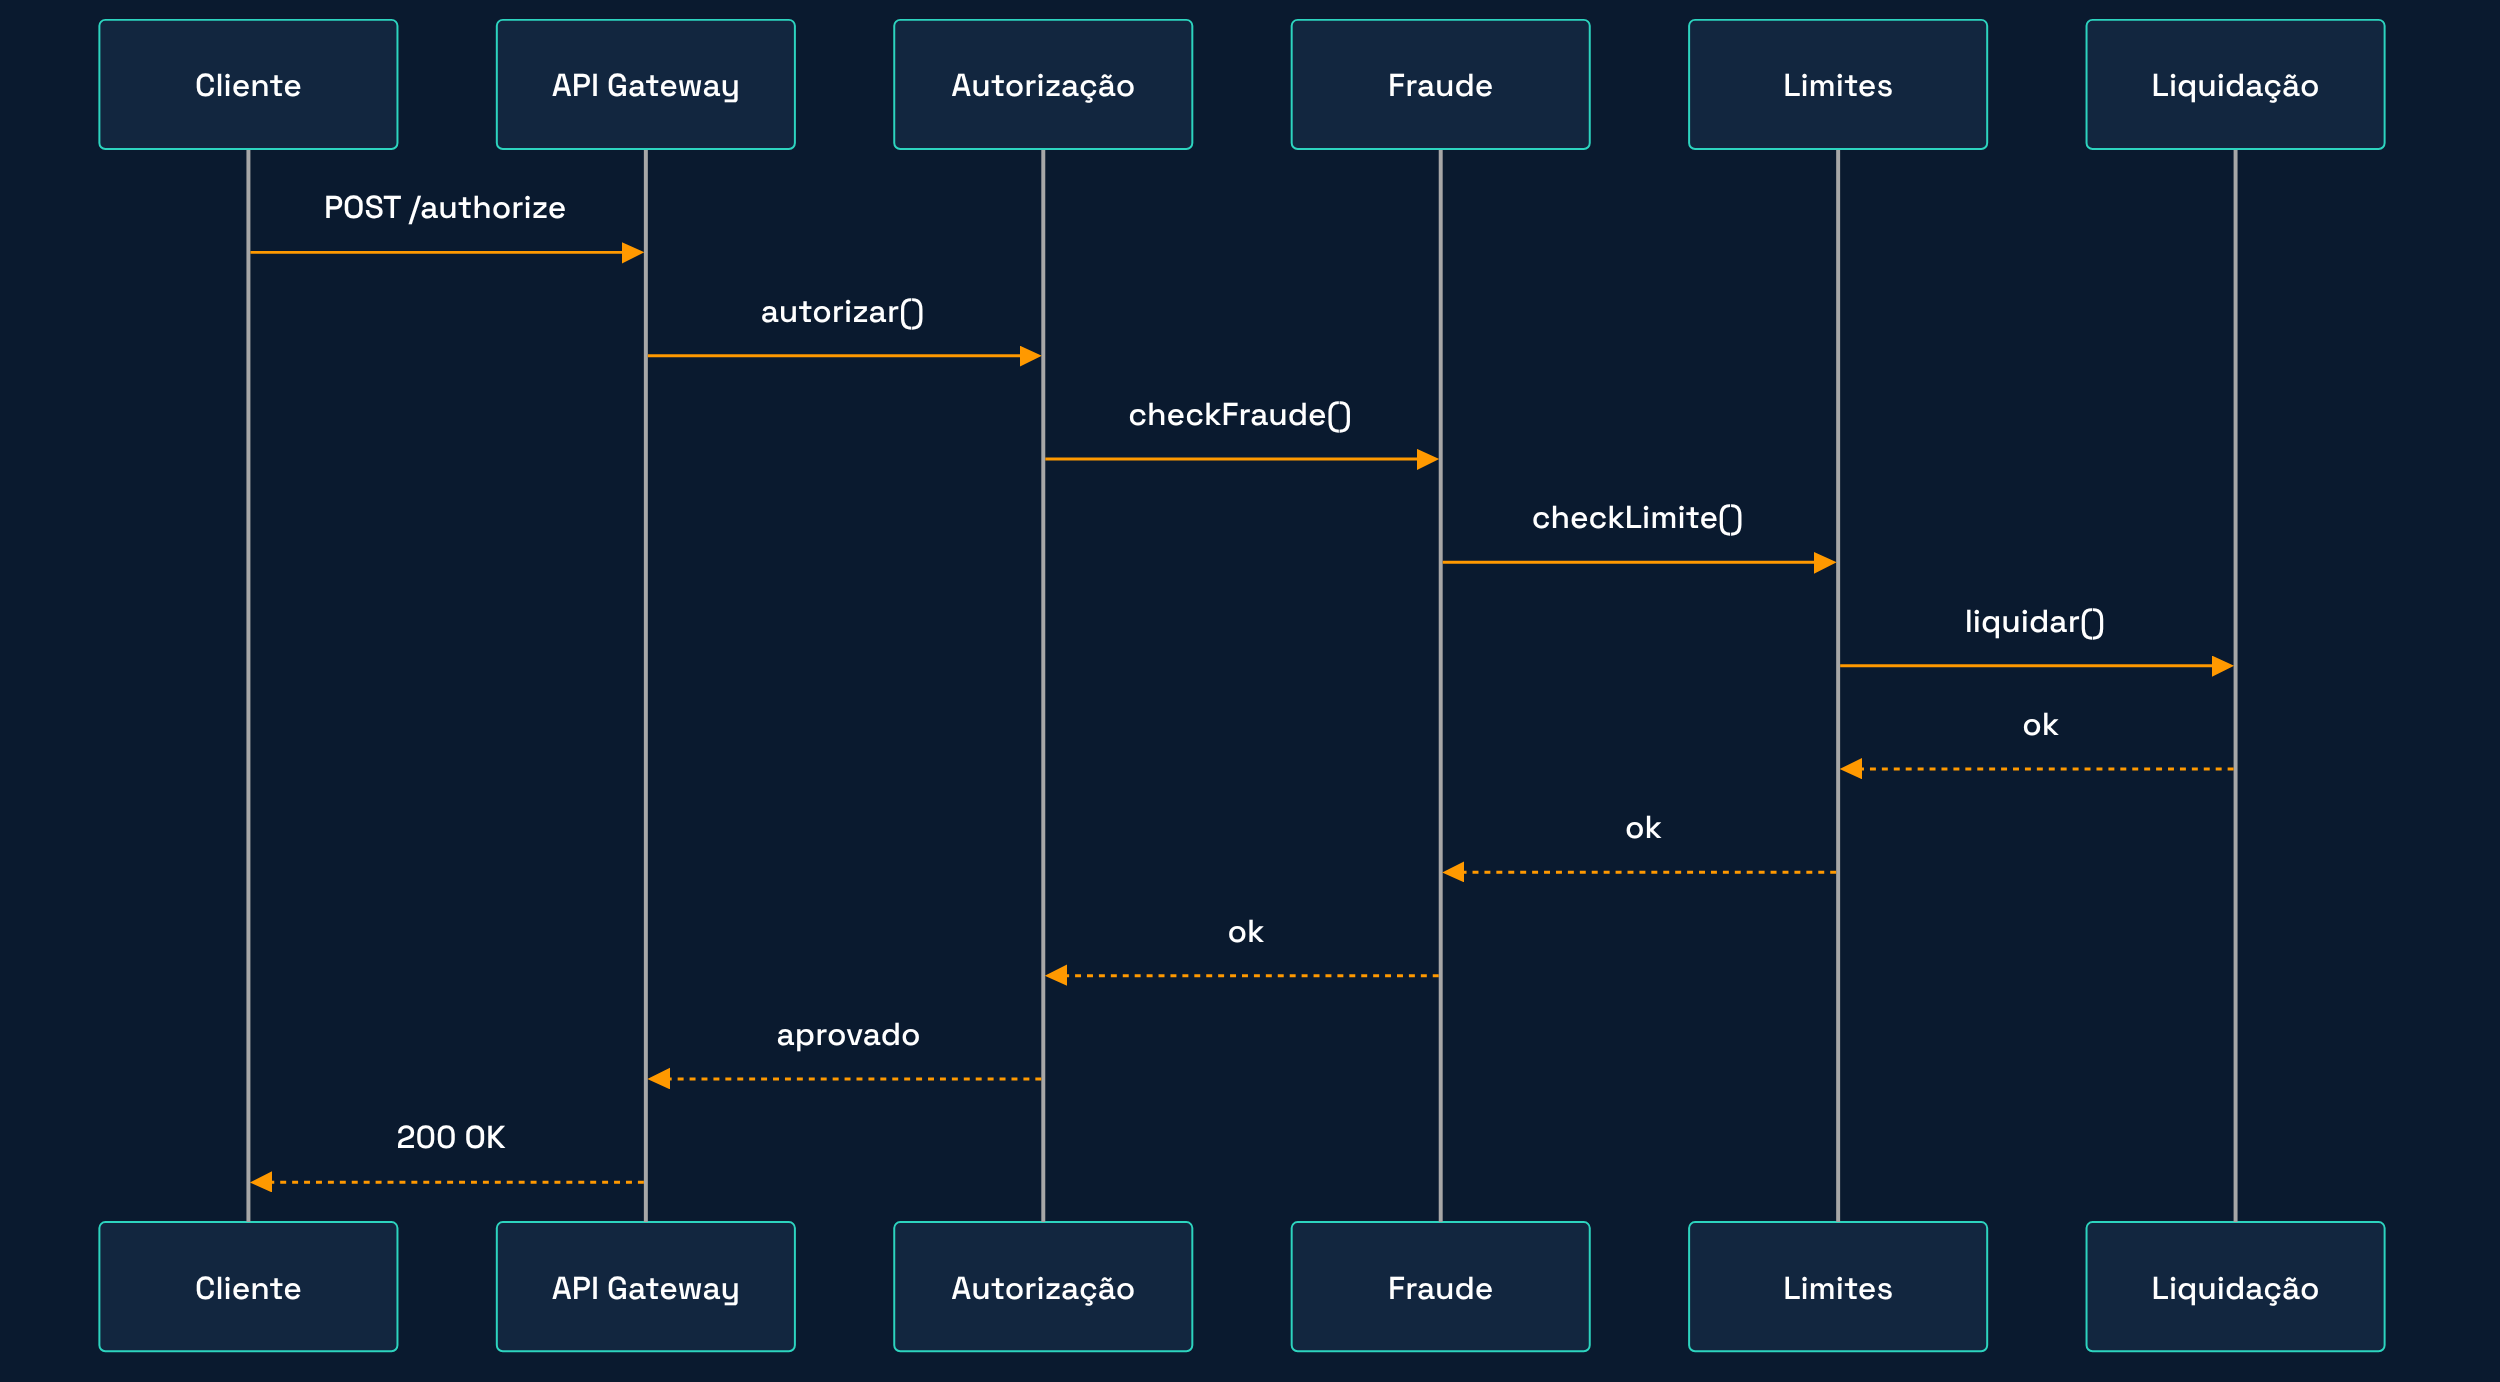
Esse é o monolito distribuído na prática: vários serviços amarrados num único fluxo linear. Cada hop acumula latência, multiplica log, tracing e retry, e adiciona mais um ponto que, se cair, derruba a transação inteira.
Em baixa carga, funciona. O problema aparece na alta concorrência: a Black Friday da abertura, uma promoção que viraliza, o volume diário de um banco digital. A latência média até parece aceitável, mas o p95 e o p99 disparam (lembra da conta de padaria?). O custo cresce junto, e o retry piora a conta: o artigo da Amazon Builders' Library sobre timeouts e retries descreve uma cadeia de cinco camadas em que cada uma tenta três vezes, e a carga que chega no banco lá embaixo multiplica por 243. Em serverless o custo da espera é literal: numa cadeia síncrona de Lambdas, as funções de cima continuam rodando (e sendo cobradas pela duração) enquanto esperam as de baixo, o anti-pattern que a própria AWS documenta. E basta um percentual pequeno de transação lenta para a frustração aparecer.
Como a gente chegou aqui
Ninguém acordou um dia querendo construir um monolito distribuído, então vale entender por que esse padrão se espalhou tanto. Na onda da adoção de microsserviços, uma situação virou rotina: “preciso de uma informação que está em outro microsserviço”. Até aí, tudo bem, isso é normal e aceitável em qualquer sistema distribuído. O problema foi a resposta, que virou quase um mantra: “então cria uma API, o outro serviço expõe e eu consumo”. Era o by the book de muita empresa, e eu vi esse padrão se repetir em projeto que participei e em conversa com gente da área.
E era atraente. Se apoiava em boa prática: REST API bem documentada, contrato em OpenAPI/Swagger, integração rápida. Por um tempo funcionou. Quando o domínio passa a exigir baixa latência, alta disponibilidade e resiliência, o modelo mostra a costura. Cada dependência síncrona nova é mais acoplamento temporal. O que nasceu para desacoplar virou outro tipo de acoplamento, distribuído e bem mais caro de manter.
Faz o teste em casa
Quer saber se essa história é a sua? Faz um exercício mental, sem derrubar nada em produção: escolhe um serviço do seu sistema e imagina ele fora do ar agora. Quantos outros param junto? Se a resposta for “a transação inteira”, o acoplamento invisível já mora aí.
Uma variação útil para levar para a daily: dá para fazer o deploy desse serviço num horário de pico sem avisar os times vizinhos? Se a resposta é não, essa independência só existe no organograma. E esse é justamente o critério do Sam Newman: quando um conjunto de serviços precisa ir para produção junto, você tem um monolito distribuído.
Onde a independência realmente se desenha
Se o runtime não decide, quem decide é a forma como os serviços conversam. Cadeia síncrona cria acoplamento temporal e deixa tudo frágil. O caminho contrário também tem nome e ferramenta: Event-Driven Architecture (EDA) para reduzir dependência direta, boundary claro de domínio para cada serviço ser dono do próprio dado, e a separação entre o hot path (o caminho rápido, que o usuário está esperando) e os side-effects (analytics, notificação, e-mail de recibo, que podem rodar em paralelo sem segurar ninguém na fila). O Werner Vogels resumiu isso no keynote do re:Invent 2022 com um “the world is event-driven”: o mundo real é assíncrono, e a arquitetura agradece quando você para de fingir que não.
O mesmo pagamento, agora event-driven
Volta na escada de pagamentos. No redesenho, o hot path guarda só o que decide a aprovação: autorização consulta fraude e limites, responde o cliente e publica um evento de “pagamento autorizado”. Liquidação, notificação e analytics viram consumidores desse evento, rodando em paralelo, cada um no seu ritmo. Se a liquidação estiver fora do ar, a autorização continua respondendo, e o evento espera na fila até ela voltar. O transporte desse evento pode ser fila, bus ou stream, e cada escolha tem seu trade-off de ordem, replay e custo (comparei as opções de streaming no post sobre Kinesis, Firehose, Flink ou MSK).
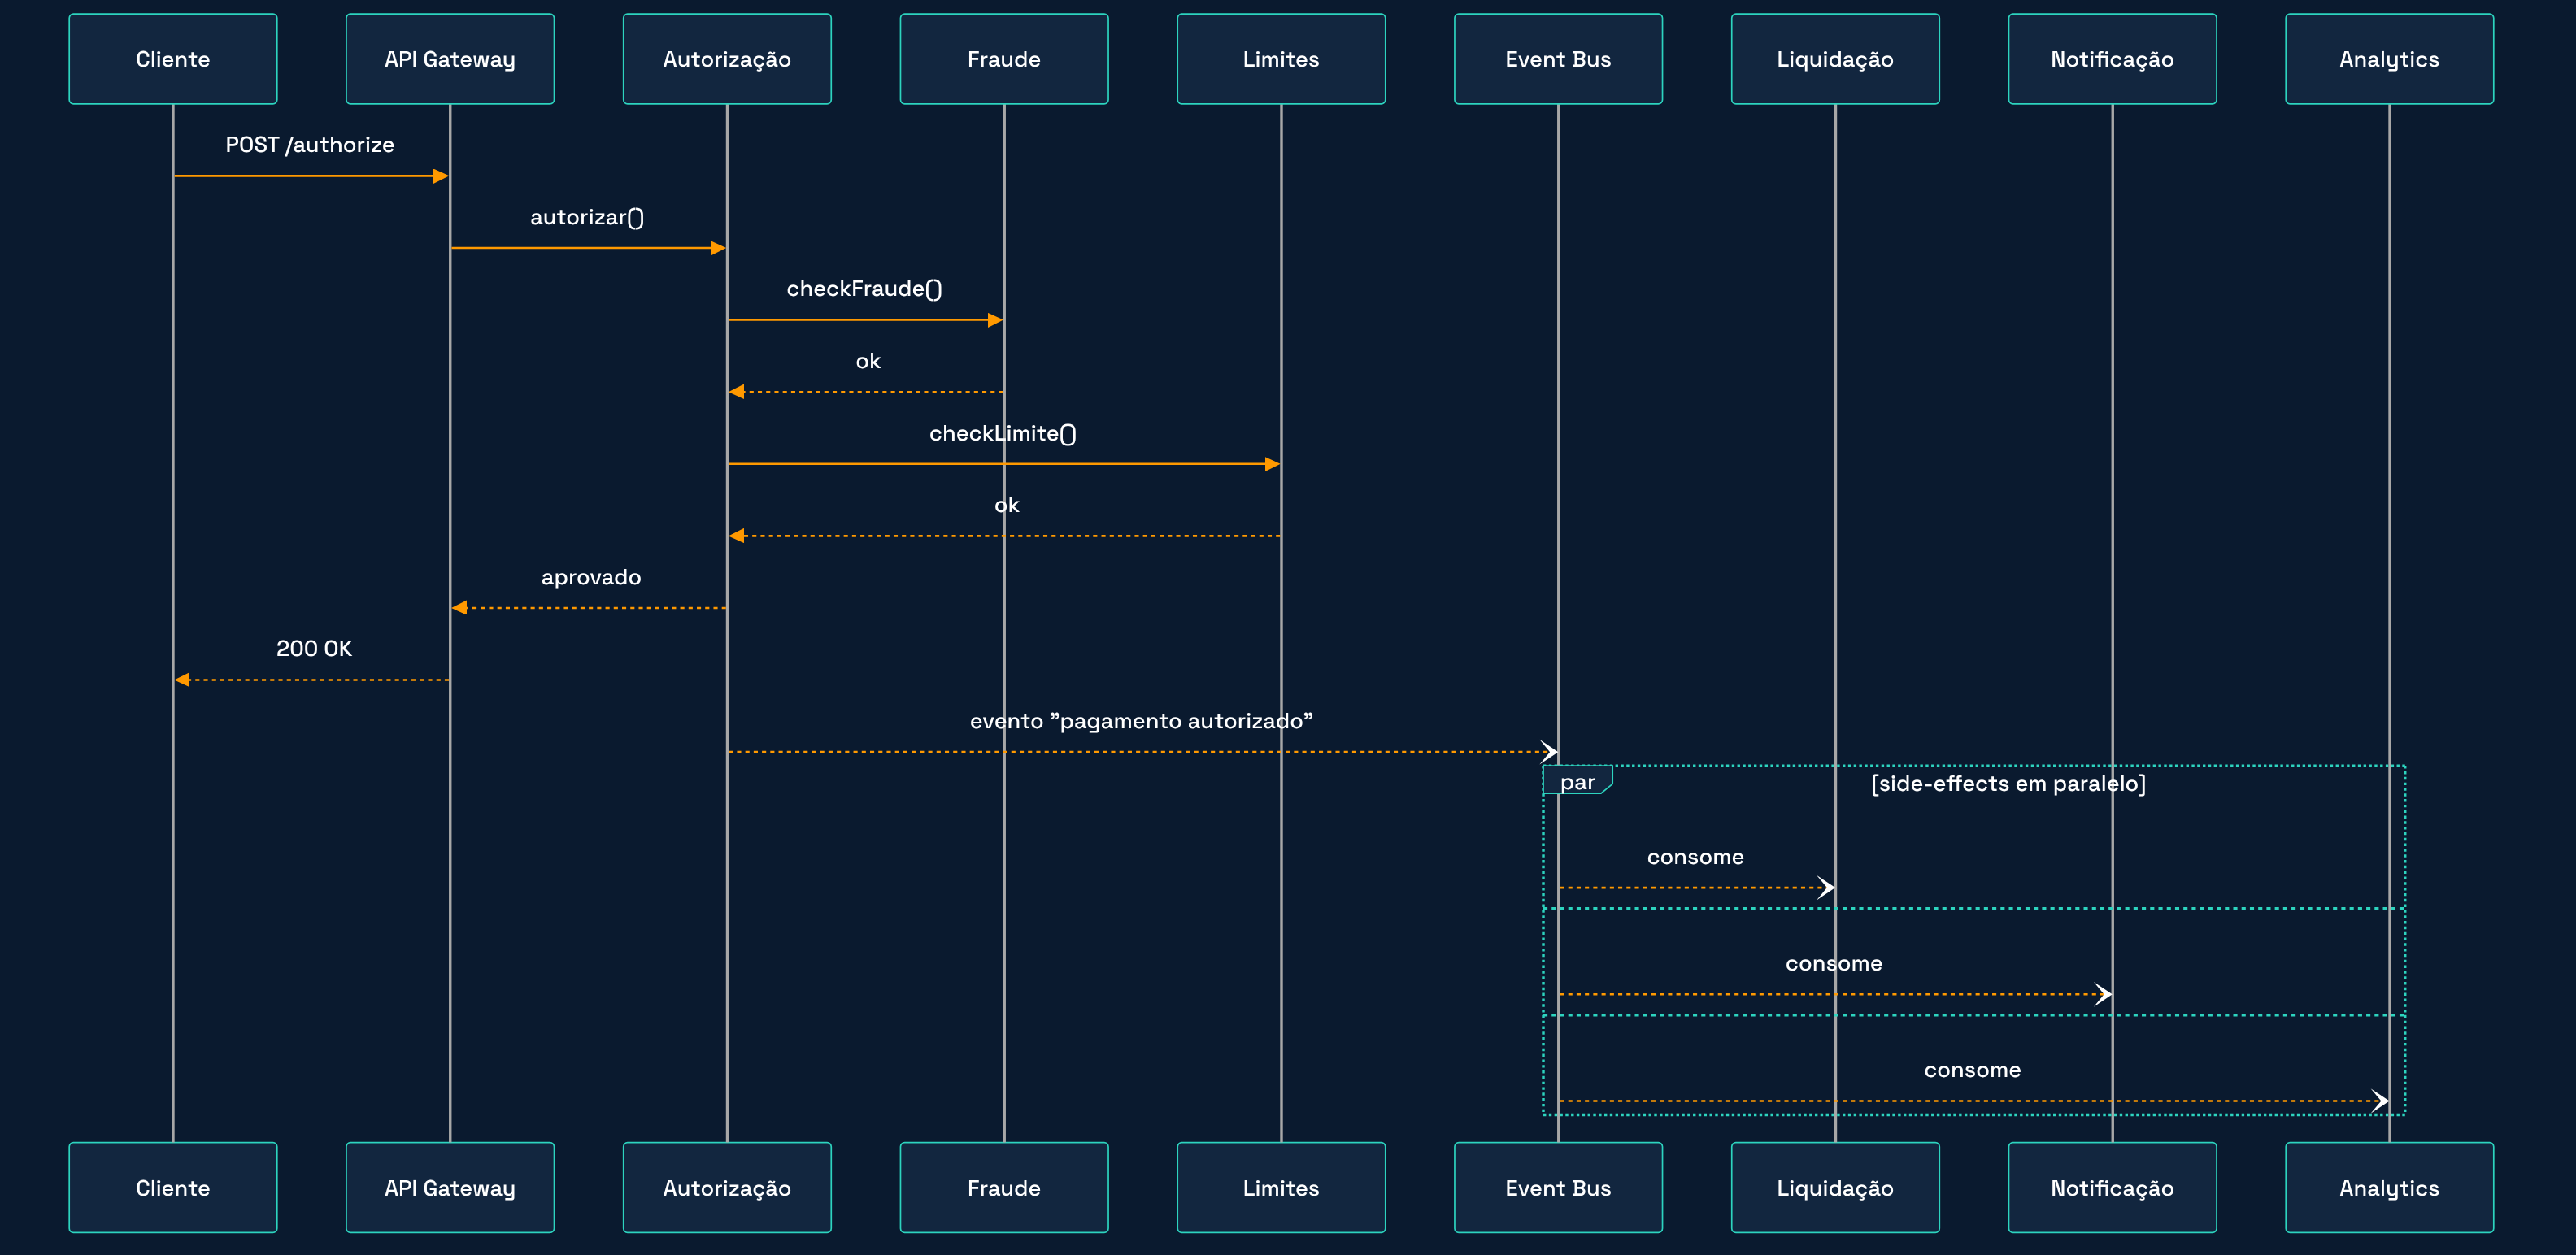
No mundo dos cartões, a liquidação já é assíncrona por natureza: a autorização acontece na hora, e a compensação e a liquidação vêm depois, em geral em lote. O desenho síncrono que a gente viu antes estava brigando com o próprio domínio.
Tem uma caixa de ferramentas inteira por trás dessa quebra (Circuit Breaker, Bulkhead, Outbox, CQRS, Saga, idempotency key) e, principalmente, a decisão de quando usar cada uma. E nenhuma vem de graça: no post sobre o preço da resiliência em arquitetura eu defendi que resiliência é decisão com custo, e cada pattern desses entra nessa conta. O resto é assunto dos próximos posts da série, onde eu vou pattern por pattern. Por agora, segura a ideia central: o que separa um microsserviço independente de um refém é a integração.
Isso encosta direto no pilar de Reliability do Well-Architected. Uma das boas práticas dele, implementar dependências fracamente acopladas, recomenda tornar as interações assíncronas onde der, com uma camada durável no meio (fila do Amazon SQS, stream do Kinesis, AWS Step Functions), justamente para a falha de um componente ficar isolada em vez de derrubar a cadeia inteira.
Lembra da cena lá do começo, o checkout inteiro dando timeout porque a liquidação, no fim da cadeia, engasgou? No desenho event-driven, aquela mesma lentidão vira fila acumulando, e o cliente recebe a aprovação. Quem derrubou o checkout foi o desenho de uma cadeia feita para cair junto, e desenho se refaz. Sem reescrever o sistema do zero e sem migrar de runtime, o trabalho é olhar as integrações uma a uma e perguntar quais delas realmente exigem resposta na hora.
E aquele comentário do começo?
Volto a ele porque o post inteiro é uma resposta. Na primeira parte, ele acertou o sintoma: um microsserviço que depende de outro, que depende de um terceiro, fica lento e caro. Só errou o culpado. A latência vem da cadeia síncrona, e ela fica igualmente lenta em container, em VM ou em Lambda. E boa parte do custo que ele colocou na conta do serverless é o custo de esperar: Lambda chamando Lambda paga pela duração enquanto aguarda a resposta. Tira a espera do caminho, com o hot path enxuto e o resto virando evento, e essa conta cai junto com a latência.
Na segunda parte, sobre processamento pesado, ele tem um ponto. Workload de CPU alta e constante pode sair mais barato em container, e essa escolha de runtime vale ser feita caso a caso. Só que é outra conversa. Trocar Lambda por container numa cadeia síncrona só muda o lugar onde a espera acontece.
O que você leva deste post
Se eu pudesse deixar você com poucas ideias na cabeça, seriam estas:
-
Se o seu serviço só responde quando outro respondeu antes, ele faz parte de um monolito distribuído.
-
Acoplamento temporal é o vilão: a latência e a disponibilidade de um serviço contaminam toda a cadeia, e a conta aparece no p95/p99, bem longe da média.
-
Trocar o runtime não conserta cadeia síncrona. Serverless ou container, o que pesa é o desenho da integração.
-
Independência se desenha: EDA, boundary claro, hot path separado dos side-effects, e os patterns de resiliência com nome (Circuit Breaker, Bulkhead, Outbox).
Então, respondendo de vez àquele comentário: a pergunta nunca foi usar ou não usar serverless. O que decide se o seu sistema aguenta a Black Friday é como você desenha a integração entre os serviços, e isso vale para qualquer runtime.
No próximo post da série eu mostro como quebrar essas dependências na prática, separando o hot path dos side-effects para derrubar a latência e tornar os microsserviços realmente independentes.
Antes disso, quero ouvir você: já ouviu (ou já falou) que serverless fica caro quando um serviço depende do outro? Depois deste post, o argumento continua de pé? Comenta aqui, manda aquele joinha e compartilha para fortalecer, valeu demais!
BUILD. SCALE. REPEAT. =D