🇺🇸 Also available in English: Lambda MicroVMs: shell access, lifecycle hooks and the best practices that matter
Deixa eu te contar uma cena que quem é de infra vai reconhecer na hora. Quando a Lambda nasceu, lá em 2014, e começou a se espalhar, a galera de infraestrutura chegava e perguntava: "mas como eu conecto na Lambda para ver se está rodando? Dar um ps, um tail, olhar a aplicação por dentro?". E a resposta era sempre a mesma: não conecta. Função é caixa preta, você olha pelo CloudWatch e reza.
Pois é. Com o Lambda MicroVMs, agora dá para conectar um shell de verdade. =D Neste post eu mostro como abrir esse shell, como implementar em Node os lifecycle hooks que mantêm a MicroVM saudável, e as best practices oficiais de performance, segurança e custo.
Conectar um shell na Lambda MicroVM
Tem dois caminhos. No console, você seleciona a MicroVM e clica em Connect. No CLI, você gera um token de shell e conecta:
aws lambda-microvms create-microvm-shell-auth-token \
  --microvm-identifier <id> --expiration-in-minutes 30

# já dentro, lista e entra na task:
ctr task ls
ctr task exec -t --exec-id shell <id> /bin/sh
Shell é opt-in. A MicroVM precisa ter sido lançada com o network connector SHELL_INGRESS, e se ela subiu sem esse connector o create-microvm-shell-auth-token devolve um ValidationException. Como os connectors são definidos no run-microvm e não mudam com a MicroVM rodando, você decide na largada quais MicroVMs aceitam essa porta de entrada.
Para o resto do debug, três campos ajudam muito: o terminationMessage no get-microvm (para MicroVM que morreu), os logs de build no CloudWatch em /aws/lambda-microvms/<image-name>, e o StateReason quando um network connector fica em FAILED.
Lifecycle hooks: o que segura a MicroVM de pé
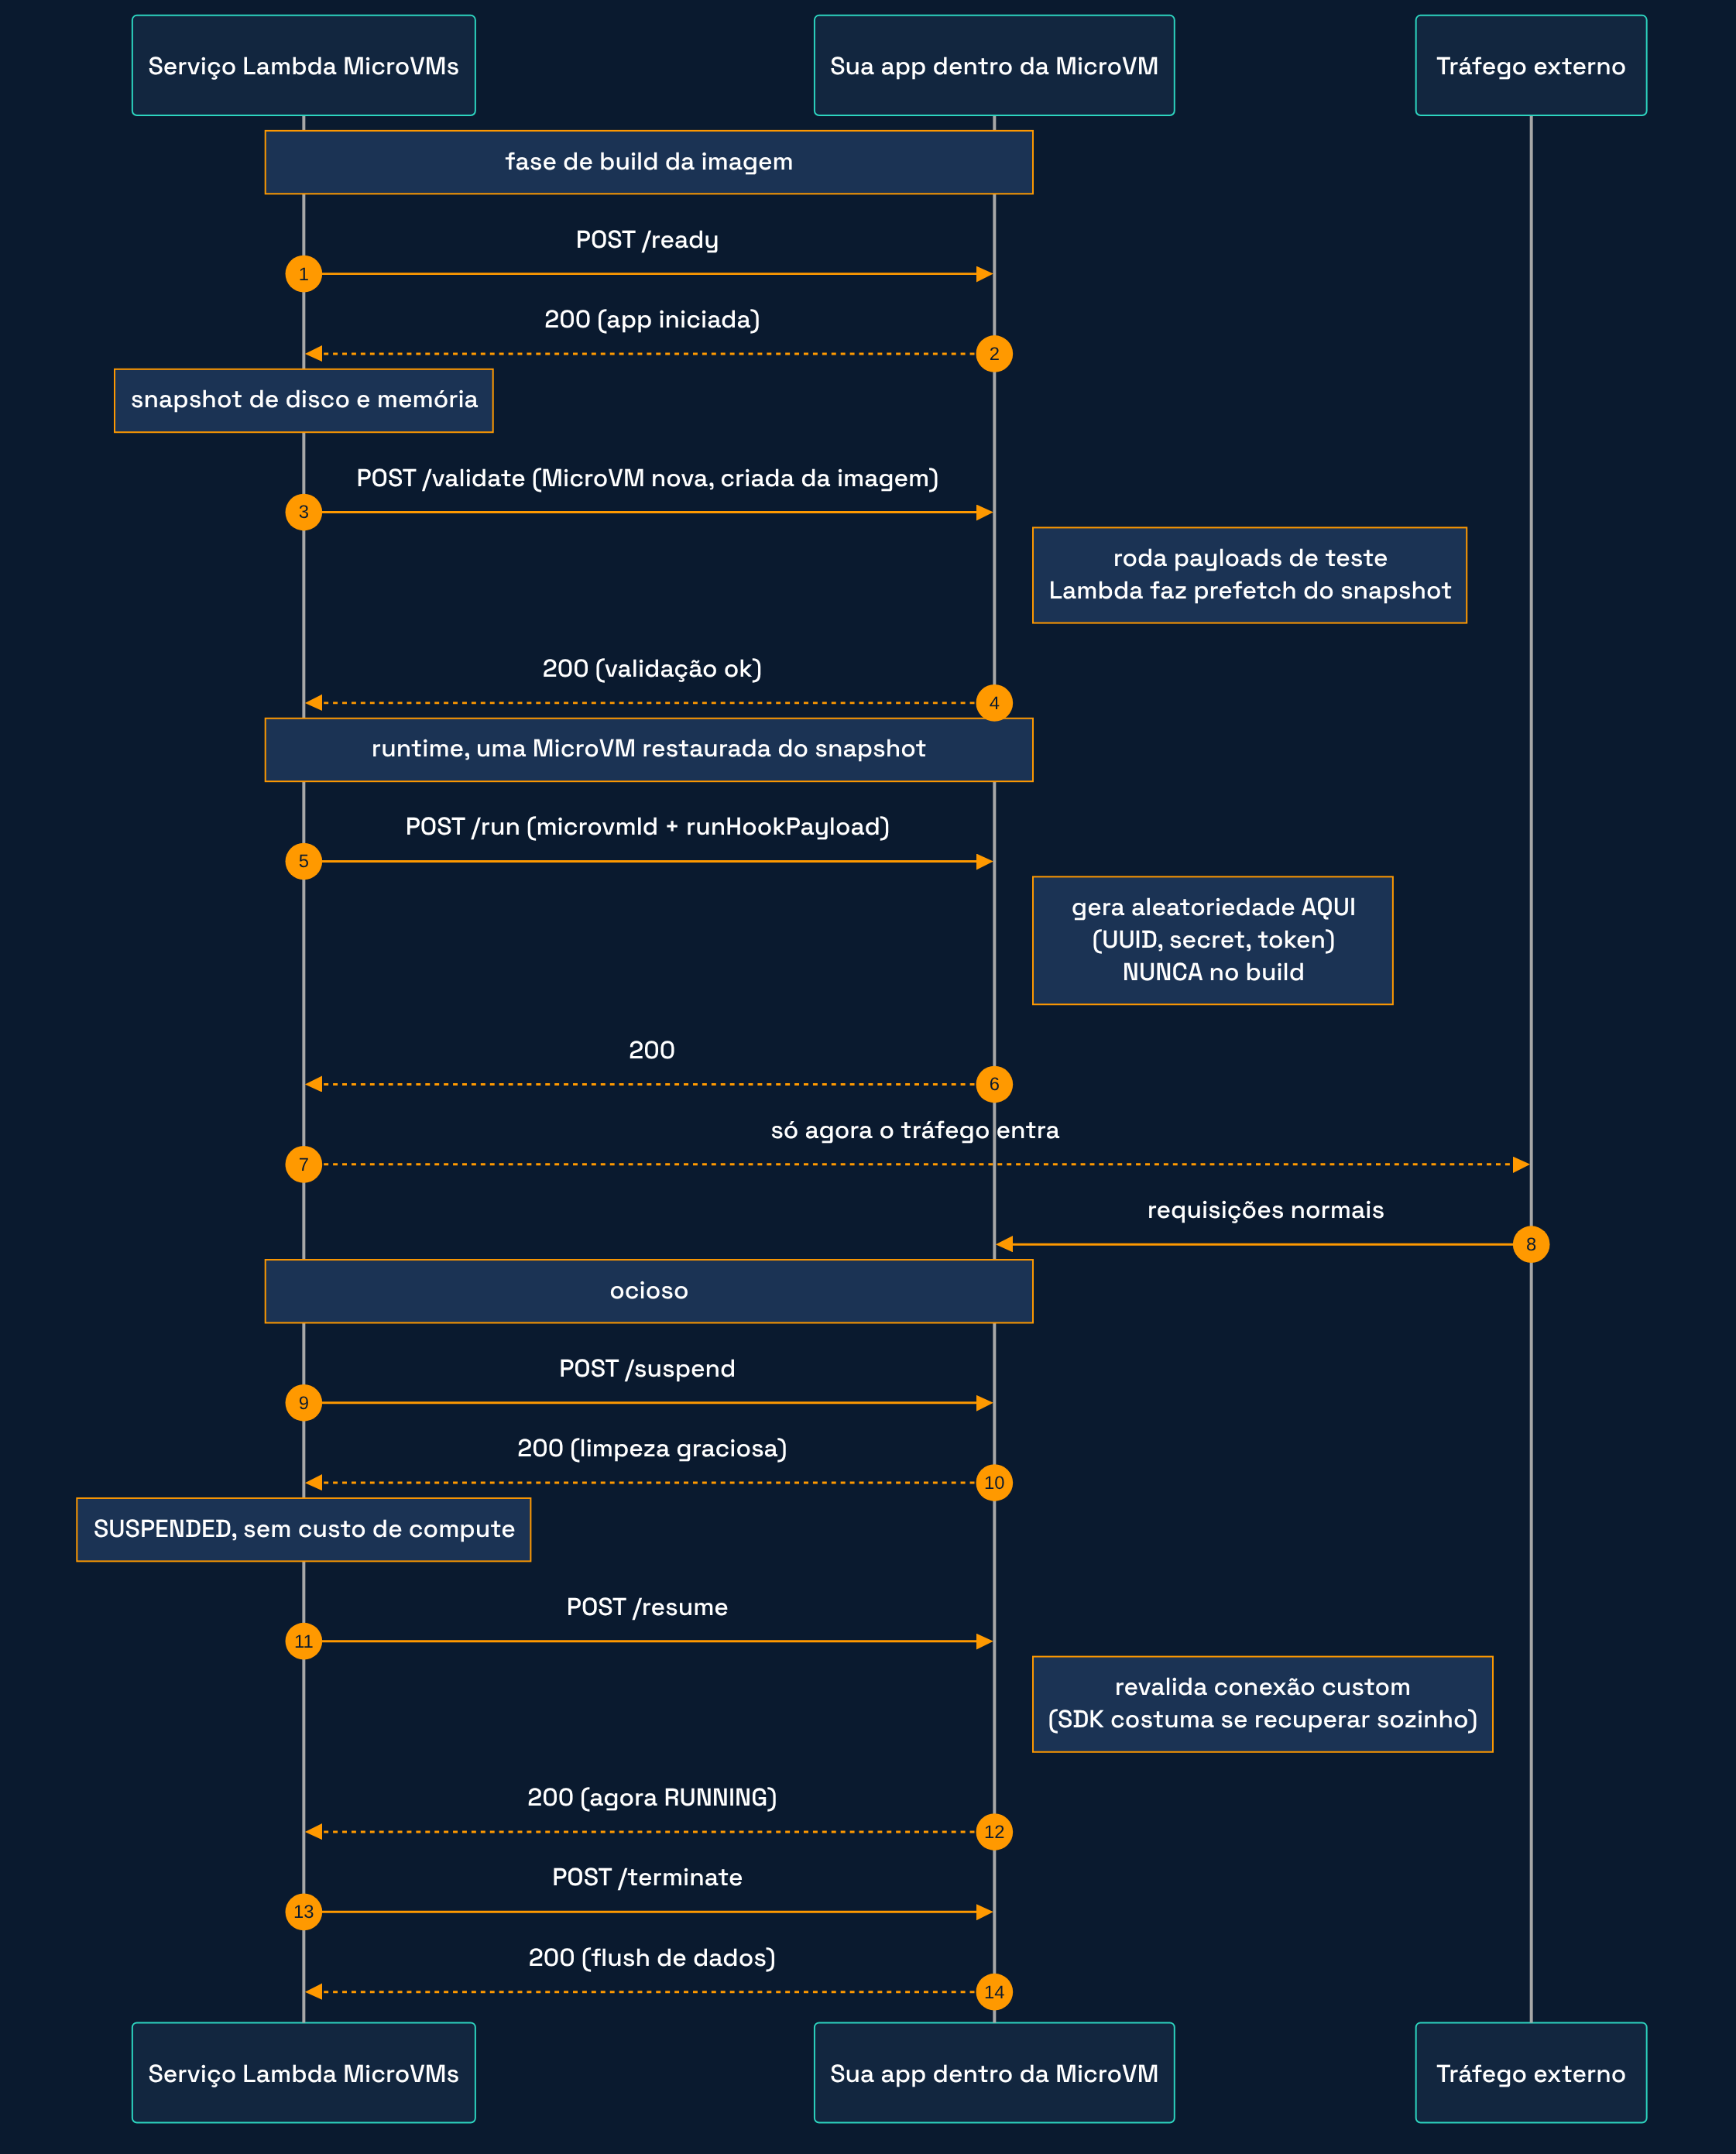
Lembra do caveat do snapshot (a MicroVM sobe de um estado congelado, então o que precisa ser fresco não pode estar congelado)? A AWS resolve isso com lifecycle hooks: quatro endpoints HTTP que a sua app implementa e que o serviço chama com um POST na hora certa.
-
/run: pós-inicialização. É aqui que você gera UUIDs, secrets e valores aleatórios, nunca no build da imagem, senão todas as MicroVMs nascem com o mesmo “aleatório”. Use CSPRNG. O/runtambém recebe no body orunHookPayload(config por MicroVM, como o ID do tenant, numa string de até 16 KB que você passa com--run-hook-payloadnorun-microvm) e omicrovmId, que o Lambda injeta. -
/suspend: limpeza graciosa antes de suspender (flush de escrita pendente, fechar conexão, liberar recurso). -
/resume: revalida conexões e estado em cache. Conexão de AWS SDK costuma se recuperar sozinha; conexão custom pode não se recuperar, então cheque aqui. A MicroVM continuaSUSPENDEDenquanto esse hook roda e só viraRUNNINGquando ele responde 200. -
/terminate: flush de dados antes de encerrar. Ele só roda na terminação final; antes de suspender, quem trabalha é o/suspend.
Os hooks chegam no path /aws/lambda-microvms/runtime/v1/<hook>, numa porta que você configura, e o tráfego externo só começa a entrar depois que o /run responde 200. Se o /run falhar ou estourar o timeout, a MicroVM pode ir direto para TERMINATING sem nunca chegar em RUNNING, então trate erro e timeout dentro do hook.
Sobre a porta: a doc não manda separar hooks e app, e no exemplo abaixo os dois dividem a 8080, que é a porta default do tráfego externo. Vale decidir isso de propósito, olhando quais portas o token de acesso libera no allowedPorts.
Também existem dois hooks da fase de build da imagem. O /ready responde 200 quando a app terminou de iniciar, e aí o serviço tira o snapshot de disco e memória (enquanto não está pronto, você devolve 503 na hora e o Lambda tenta de novo até o timeout). O /validate é chamado depois do build, numa MicroVM nova criada a partir da imagem: ali você roda payloads de teste que exercitam os code paths, e o Lambda rastreia quais regiões do snapshot foram acessadas para fazer prefetch delas e reduzir a latência no startup. O /ready garante que o snapshot pega a app pronta; o /validate é o que ajuda no tempo de boot.

No nosso Node HTTP server fica assim:
const http = require("http");
const crypto = require("crypto");

let sessionSecret; // gerado no /run, NUNCA no build da imagem

function ok(res, body) {
  res.writeHead(200, { "Content-Type": "application/json" });
  res.end(JSON.stringify(body));
}

const server = http.createServer((req, res) => {
  const HOOK = "/aws/lambda-microvms/runtime/v1";
  switch (req.url) {
    case `${HOOK}/run`:        // aleatoriedade e init vivem aqui; responda 200 antes do tráfego entrar
      sessionSecret = crypto.randomUUID();
      return ok(res, { ready: true });
    case `${HOOK}/suspend`:    // limpeza antes de congelar
      return ok(res, { cleanedUp: true });
    case `${HOOK}/resume`:     // revalida conexoes/estado ao acordar
      return ok(res, { revalidated: true });
    case `${HOOK}/terminate`:  // flush de dados ao encerrar
      return ok(res, { flushed: true });
    default:
      // ... a sua aplicacao de verdade
      return ok(res, { hello: "world" });
  }
});

server.listen(8080, "0.0.0.0");
Se a app não responder depois de um resume, o suspeito número um é não ter o /resume implementado (ou a app não estar bindando na porta certa, tipo 8080, depois que acorda).
Prova rápida: o snapshot congela o seu “aleatório”
Aquele aviso de gerar aleatoriedade no /run parece detalhe até você medir. Montei uma demo pequena que roda local, na minha máquina: sem AWS, sem custo, só Node stdlib. Ela simula o build gerando o snapshot e sobe duas “MicroVMs” a partir dele. O código vai junto com o post da demo, o finale da série.
O resultado, capturado de verdade:
== 3. antes do /run: o servico nao entrega trafego ==
amostra-A  GET /  -> HTTP 503

== 5. depois do /run 200: trafego liberado ==
amostra-A  GET /  -> HTTP 200

== 6. veredito ==
token gerado no BUILD  A vs B: IGUAL     <- colide entre analises
   A: 6fcf9c71-2024-4901-acfb-2593ed5a2fbb
   B: 6fcf9c71-2024-4901-acfb-2593ed5a2fbb
token gerado no /run   A vs B: diferente <- ok
   A: 2011db3c-3120-4b9a-b89d-caa48b034c8f
   B: 496f5bfc-7c7f-4cd7-b39f-2ea3c9b8c281
Dá para ver as duas coisas na mesma saída: o token assado no build nasce idêntico nas duas, e o tráfego só passa a 200 depois que o /run responde.
Importante: essa demo não roda em Lambda MicroVMs. Ela exercita o contrato dos hooks localmente, com um snapshot.json no lugar do congelamento real. Serve para ver o comportamento. Prova do serviço de verdade só rodando numa MicroVM na AWS, e isso fica para o post da demo, o finale da série.
Best practices oficiais, organizadas por pilar
Performance. Escolha a menor MicroVM que atende o seu CPU, memória e banda (a banda escala com a memória configurada). Minimize o snapshot: remova dependências de build e arquivos temporários antes de a imagem ser capturada, isso reduz o tempo de run e de resume. E para workload sensível a latência, mantenha os ambientes mais usados em suspended para resumir rápido.
Segurança. Gere tokens curtos (15 a 30 min) e tenha lógica de refresh no cliente antes de expirar. Limite o token às portas que a app usa, com o parâmetro allowedPorts. Tráfego sensível (banco, API interna) vai por um VPC egress connector, que passa pelos seus security groups e network ACLs. E aplique least-privilege: separe a role de build (criação da imagem) da role de execução (runtime), cada uma com o mínimo. Detalhe útil: o /ready e o /validate rodam sob a role de build, e os hooks de runtime rodam sob a de execução.
Custo. Configure maxIdleDurationSeconds na idle policy para suspender MicroVM ociosa (suspensa não paga compute, só o storage do snapshot). Ponha um teto de segurança com a duração máxima (--maximum-duration-in-seconds no CLI, até 8 horas, somando tempo rodando e suspenso) para não tomar susto na fatura com instância esquecida. Use suspendedDurationSeconds para terminar sozinha a MicroVM que ficou tempo demais parada. Coloque tags nas imagens para cost allocation no Cost Explorer, e apague as versões de imagem que você não usa mais, porque elas também custam storage.
Antes de decidir quanto isolamento e quanta disponibilidade o seu caso pede, vale olhar o custo de cada degrau. Eu abri essa conta no post sobre o custo da resiliência: HA, multi-região ou on-premise.
Apps de browser: um proxy na frente da MicroVM
App que roda no navegador (um VS Code server, um IDE web) esbarra numa regra da doc: toda request para o endpoint da MicroVM precisa do token JWE no header X-aws-proxy-auth, e não existe opção sem autenticação. Quando o usuário abre uma URL, clica num link ou carrega um iframe, o browser não deixa você colocar esse header. Para WebSocket aberto pelo seu JavaScript, a doc oferece passar token e porta como subprotocols (lambda-microvms.authentication.<token>), mas isso não resolve a navegação comum.
A saída de arquitetura é um reverse proxy seu na frente (o pattern Gateway): um componente que recebe a request do browser já autenticada do jeito da sua app, busca ou gera o token da MicroVM e injeta o X-aws-proxy-auth antes de repassar. Ele também precisa de um mapa usuário → MicroVM, porque cada MicroVM tem o próprio endpoint e não há load balancing entre elas. Com esse mapa, quando o usuário fecha a aba e volta depois, você sabe para qual instância rotear. O orquestrador que já chama o run-microvm é um candidato natural para guardar esse mapa.
Se o problema for só domínio próprio, a AWS publicou um pattern com Application Load Balancer que reescreve o Host header, mas ali o cliente continua tendo que mandar o token. Ele não substitui o proxy de autenticação.
Se o que vai orquestrar essas MicroVMs é um agente de IA operando a sua conta, o outro lado dessa moeda é o controle de permissão, que eu tratei em AWS MCP Server: qual usar, quando e como configurar.
Os erros que você vai ver (e o que fazer)
Da tabela de troubleshooting da doc, os que eu deixaria anotados:
-
502 Bad Gateway: a app caiu ou não está escutando. Cheque o
EXPOSEe oCMDdo Dockerfile e os logs de runtime. Com auto-resume ligado, também pode ser a MicroVM que não conseguiu resumir (confira o estado comget-microvm). -
429 Too Many Requests: você passou do rate (da conta ou da MicroVM). Retry com backoff exponencial e jitter.
-
Conexões caindo: timeout de ocioso. Implemente keepalive (ping/pong) ou aumente o
maxIdleDurationSeconds. -
Build falhou (
CREATION_FAILED): olhe os logs em/aws/lambda-microvms/<image-name>, confira a sintaxe do Dockerfile e as permissões de S3 da role de build. Rodedocker buildlocal para reproduzir.
E o monitoramento básico: quando uma MicroVM termina do nada, o get-microvm traz o stateReason com o motivo. É o primeiro lugar para olhar.
O que você leva
-
Dá para dar shell na Lambda agora, via console ou
create-microvm-shell-auth-token, mas só se a MicroVM subiu com o connectorSHELL_INGRESS. -
Os lifecycle hooks (
/run,/suspend,/resume,/terminate) são o que mantém a MicroVM saudável. Gere aleatoriedade no/run, revalide conexão no/resume, e use o/validatepara encurtar o boot. -
Segurança: token curto com refresh, escopo por porta, VPC egress, e role de build separada da de execução.
-
Custo: suspenda no ocioso, ponha teto de duração, termine o que ficou parado e limpe versão de imagem que não usa.
Fontes
-
Core concepts (estados e transições)
-
Running and using MicroVMs (lifecycle hooks, run hook payload, suspend/resume)
-
MicroVM images (build hooks
/readye/validate) -
Security and permissions (IAM roles, tokens, shell)
-
Networking (autenticação, portas, VPC egress)
-
Adding custom domains to AWS Lambda MicroVMs with Application Load Balancer
Tem um caso de uso de MicroVM rodando aí? Conta qual hook te salvou (ou te queimou por não ter). E se você é de infra e sempre quis dar um shell na Lambda, agora é a sua hora. Manda aquele joinha, compartilha, e bora trocar ideia. Valeu demais!
BUILD. SCALE. REPEAT. =D