🇺🇸 Also available in English: New EventBridge Custom Event Bus: Do You Still Need SQS FIFO in the Middle?
Sabe aquele desenho de integração entre times? EventBridge na frente, uma SQS FIFO atrás de cada consumidor para garantir ordem e segurar retry, um archive para quando alguém pedir replay e uma resource policy que cresce a cada conta nova. Funciona, mas é muita peça para fazer um evento sair de um time e chegar em outro, na ordem certa, sem sumir.
Em 24 de setembro de 2026 a AWS relançou o Custom Event Bus do Amazon EventBridge. O bus que você conhece virou “Custom Event Bus - Classic”, e o novo chegou com compartilhamento via AWS RAM, retenção nativa, replay, ordenação por EventGroupId, deduplicação no publish e cobrança por GB. Com isso tudo dentro do bus, dá para tirar a SQS FIFO (ou o Kinesis) do meio da integração? Bora ver onde sim e onde não, com os números da doc.
O que muda no EventBridge Custom Event Bus novo
Pensa num condomínio. No Classic, o síndico (a conta dona do bus) recebe a correspondência e decide, por regra escrita à mão, para qual apartamento vai cada carta. Morador novo pede mais uma rule. No bus novo, o prédio ganhou caixas postais: o síndico libera o acesso, cada morador instala a sua com o próprio filtro e ainda pode pedir as cartas da semana passada, porque o prédio guarda tudo por um tempo.
A tabela oficial de comparação:
| Custom Event Bus (novo) | Custom Event Bus - Classic | |
|---|---|---|
| Cross-account | AWS RAM; cada conta consumidora é dona dos próprios subscribers | Resource policy ou bus-to-bus |
| Retenção | Nativa, de 1 a 365 dias (default 1 dia) | Não retém; precisa de archive |
| Ordenação | FIFO por event group, por subscriber | Não tem |
| Replay | Starting position do subscriber | Replay de archive |
| Publish | PutEvents (JSON) e PutRawEvents (Avro, Protobuf e outros) | PutEvents (JSON) |
| Deduplicação | No publish, por conteúdo ou por chave sua | Não tem |
| Targets | 1 por subscriber | Até 5 por rule |
A peça nova é o subscriber (o par rule + target do Classic, lembra?). Ele observa um bus, filtra, transforma se você quiser e entrega para exatamente um target, com retry policy e DLQ próprios.
Em Enterprise Integration Patterns, o bus novo junta o Publish-Subscribe Channel que o EventBridge já era, o Durable Subscriber (o consumidor pausa, volta e não perde nada) e um Dead Letter Channel por consumidor.
O desenho multi-conta: bus central, subscribers por conta
O caso que o lançamento resolve melhor é o barramento entre times. Uma conta de plataforma é dona do bus, compartilha via RAM com contas, OUs ou a organização inteira, e sai do caminho. Cada time cria os seus subscribers na conta dele. A conta consumidora vê só os subscribers dela; a dona vê todos e pode revogar qualquer um com RevokeResource.
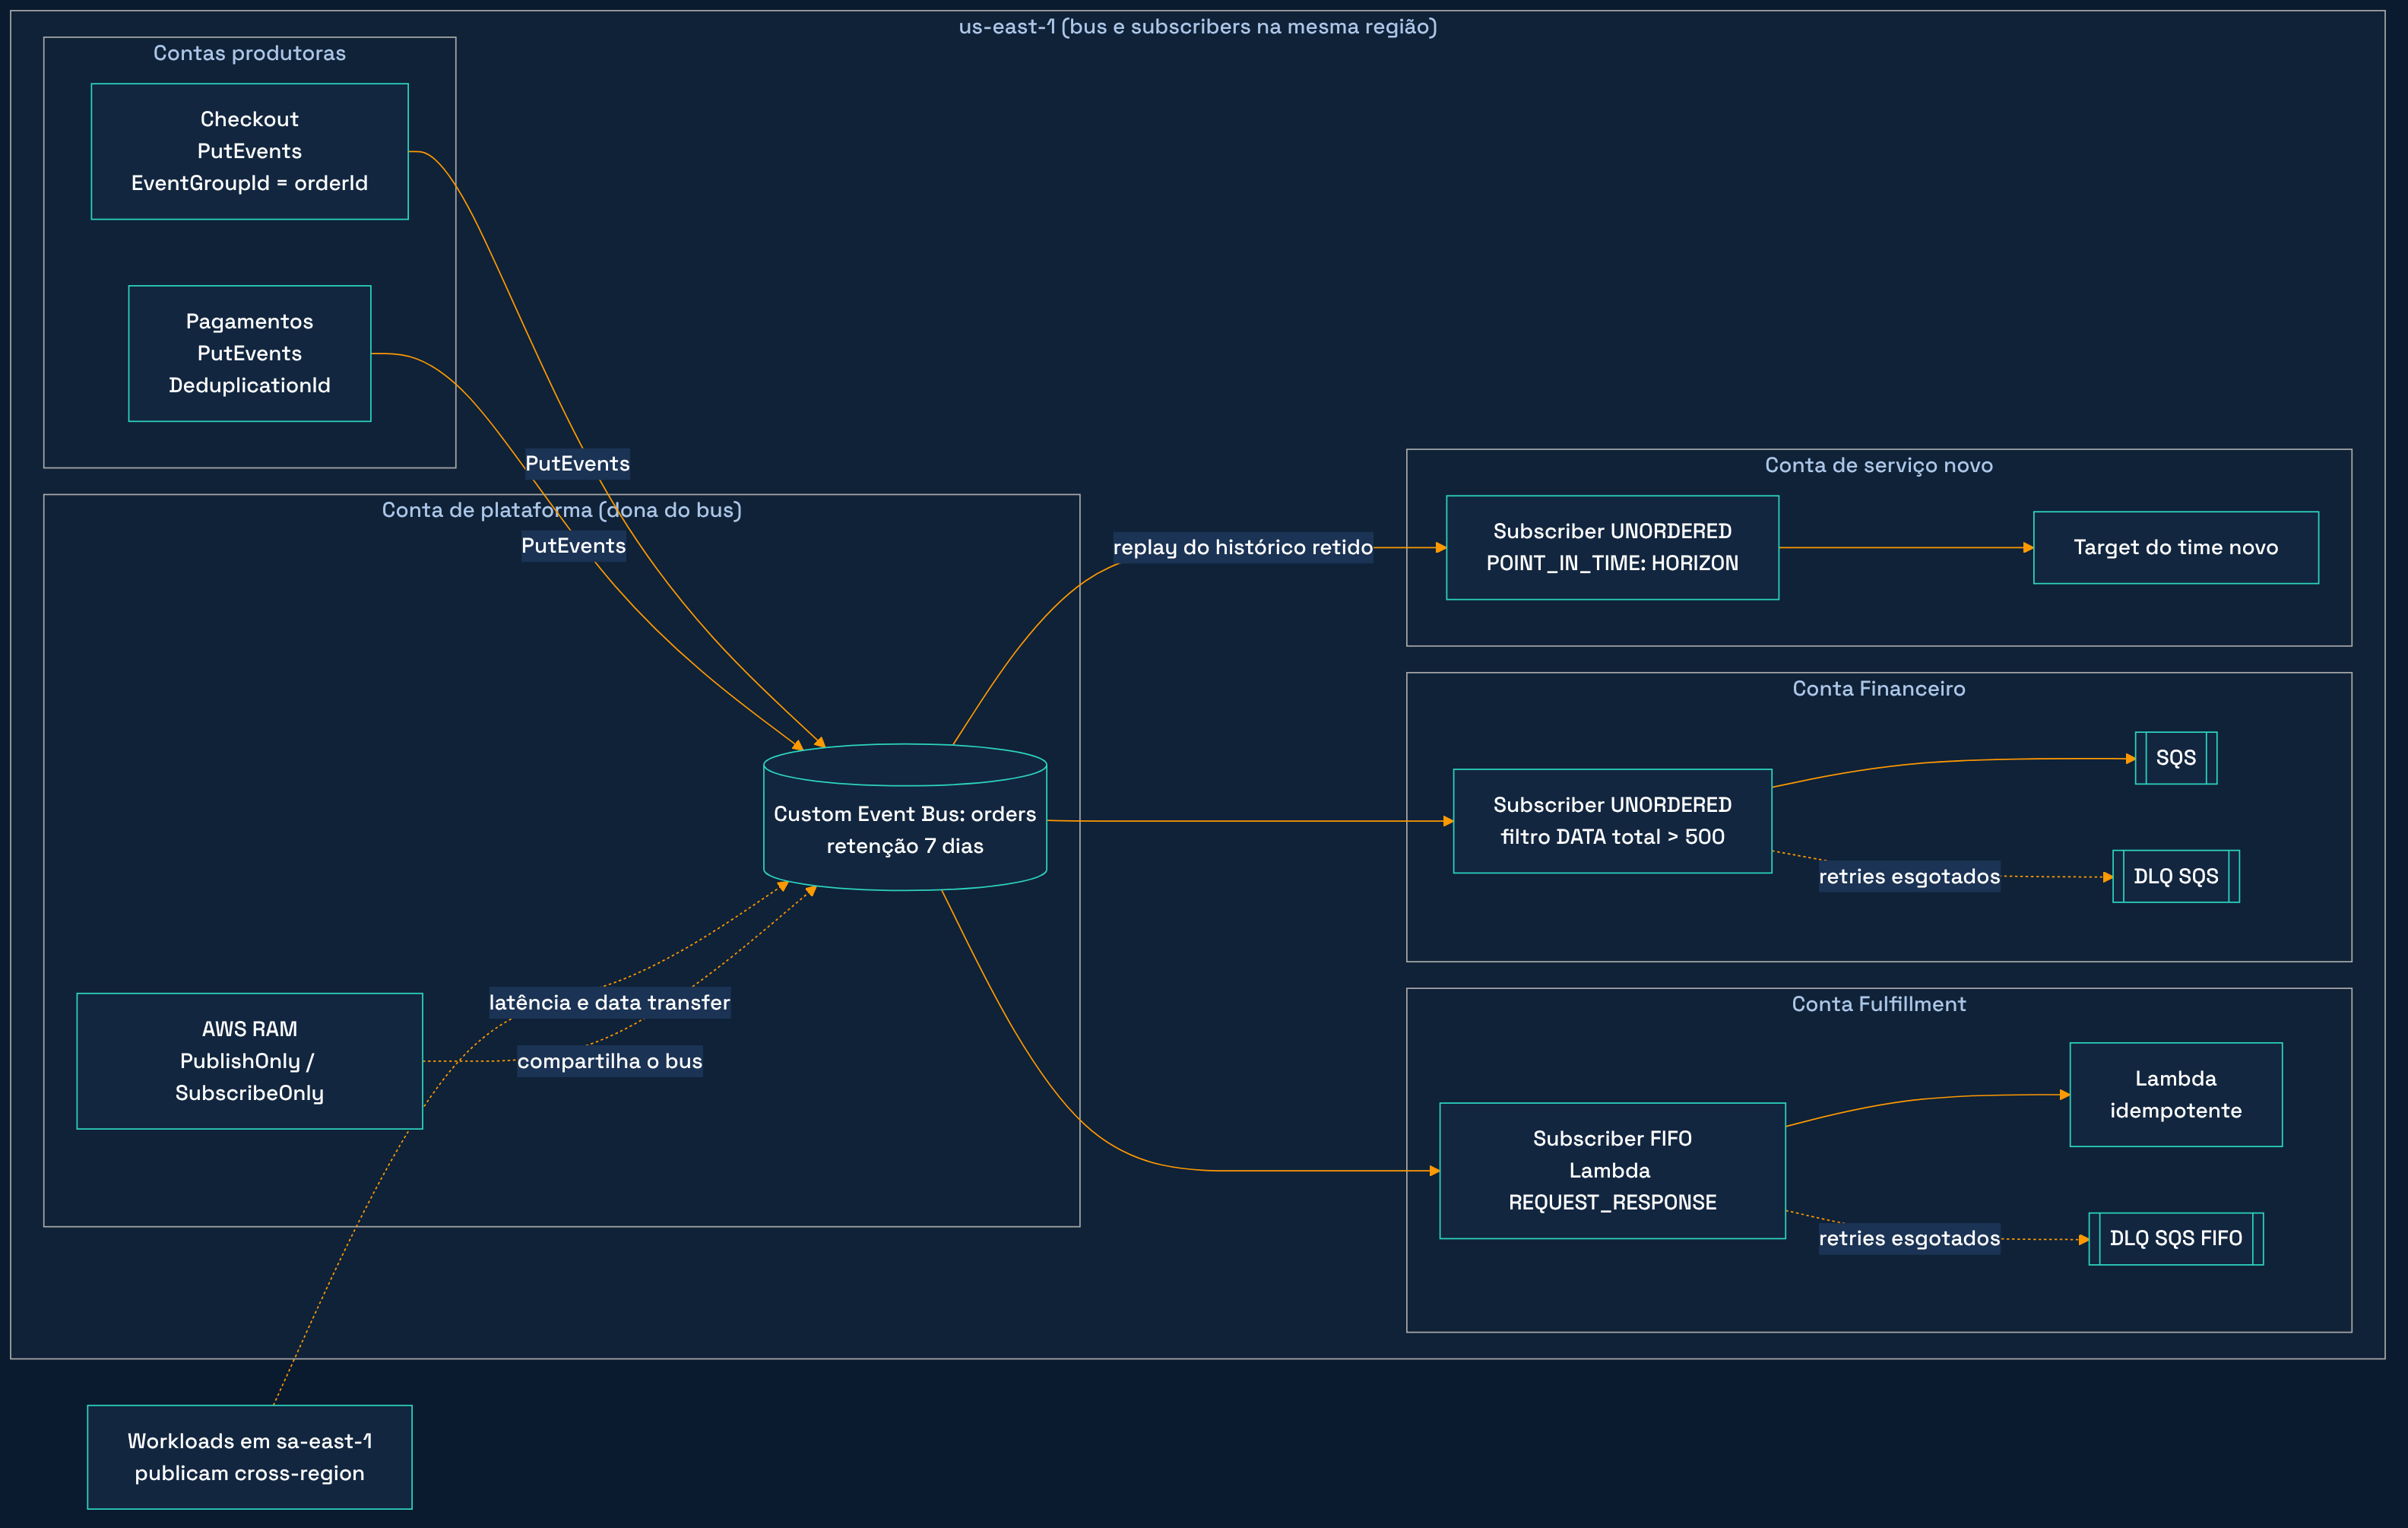
O RAM traz quatro managed permissions (publish, subscribe, event sources ou as três), como AWSRAMEventBridgeEventBusV2PublishOnly e AWSRAMEventBridgeEventBusV2SubscribeOnly. Dá least-privilege por papel: checkout só publica, financeiro só assina. Encosta no pilar de Security do Well-Architected: a permissão sai da resource policy escrita à mão e vai para um compartilhamento auditável.
Mão na massa. Na conta de plataforma, o bus com 7 dias de retenção e o share para uma conta consumidora (comandos da doc oficial, com os IDs de exemplo dela):
aws eventsv2 create-event-bus \
    --name orders \
    --storage-configuration RetentionPeriodInDays=7

aws ram create-resource-share \
    --name orders-bus-share \
    --resource-arns arn:aws:events:us-east-1:111122223333:event-busv2/orders/EXAMPLE1234567890abcdef \
    --principals 444455556666 \
    --permission-arns arn:aws:ram::aws:permission/AWSRAMEventBridgeEventBusV2SubscribeOnly
Repara no eventsv2: CLI, SDK (EventBridgeV2) e endpoint ganharam o sufixo, e o namespace no CloudFormation é AWS::EventsV2. No IAM, a action continua com prefixo events:. Uma policy com eventsv2:PutEvents passa na validação, não concede nada e o caller toma AccessDeniedException.
Na conta consumidora, o subscriber em CloudFormation. É o trecho do template oficial (AWS::EventsV2::Subscriber), com o ARN do bus vindo por parâmetro, porque export não atravessa conta:
Parameters:
  OrdersBusArn:
    Type: String

Resources:
  LargeOrders:
    Type: AWS::EventsV2::Subscriber
    Properties:
      Name: large-orders
      EventBusArn: !Ref OrdersBusArn
      FilterConfiguration:
        Filters:
          - Scope: DATA
            Pattern: '{"detail":{"total":[{"numeric":[">",500]}]}}'
      InvokeConfiguration:
        TargetArn: !GetAtt OrdersQueue.Arn
        RoleArn: !GetAtt DeliveryRole.Arn
      RetryPolicy:
        MaxRetryAttempts: 10
        MaxEventAgeInSeconds: 3600
      OnFailureConfiguration:
        Arn: !GetAtt OrdersDeadLetterQueue.Arn
A fila, a DLQ e a role (com sqs:SendMessage nas duas) ficam no mesmo template, porque o RoleArn do subscriber tem que ser de uma role da mesma conta do subscriber. Resultado: uma stack na conta dona e uma em cada conta consumidora, e o roteamento deixa de ser fila de ticket do time de plataforma.
Dois limites pegam pipeline de IaC: só 1 create ou delete de subscriber em andamento por bus, somando todas as contas (o segundo leva ConcurrentModificationException), e no máximo 24 mudanças de filtro por subscriber em 24 horas. Com dez times no mesmo bus, ponha retry com backoff no pipeline.
Retenção e replay: o archive virou starting position
No novo bus, todo evento fica retido pelo período configurado, e o replay é só um subscriber que começa no passado. A --starting-position aceita LATEST ou POINT_IN_TIME, com HORIZON (o evento mais antigo retido) ou TIMESTAMP, e um EndPoint opcional para parar.
Dois usos ficam fáceis. Hidratar serviço novo: o subscriber nasce em HORIZON, recebe os últimos N dias e cai no fluxo ao vivo. E redrive cirúrgico, como neste exemplo da doc, que reprocessa só dois aws:EventId de uma janela de um minuto:
aws eventsv2 create-subscriber \
    --name redrive-2026-09-16 \
    --event-bus-arn arn:aws:events:us-east-1:111122223333:event-busv2/orders/EXAMPLE1234567890abcdef \
    --starting-position POINT_IN_TIME \
    --point-in-time-configuration '{ "PointType": "TIMESTAMP", "StartingPoint": "2026-09-16T18:40:00Z", "EndPoint": "2026-09-16T18:41:00Z" }' \
    --filter-configuration '{ "Filters": [ { "Scope": "SYSTEM_METADATA", "Pattern": "{\"aws:EventId\":[\"a1b2c3d4-...\",\"e5f6a7b8-...\"]}" } ] }' \
    --invoke-configuration '{ "TargetArn": "arn:aws:sqs:us-east-1:111122223333:large-orders", "RoleArn": "arn:aws:iam::111122223333:role/EventBusDeliveryRole" }'
Todo evento entregue carrega aws:DeliveryType como LIVE ou REPLAY. Ajuda, mas o consumidor tem que ser Idempotent Receiver de qualquer jeito (numa Lambda, o utilitário de idempotency da AWS Lambda Powertools é o caminho mais curto). E a quantidade de subscribers fazendo replay ao mesmo tempo é limitada por bus, sem valor publicado: o “todo mundo reprocessa depois do incidente” vai bater em LimitExceededException.
Ordenação por EventGroupId e deduplicação: o que a garantia cobre
O subscriber tem Type UNORDERED (paralelo, mais vazão) ou FIFO. No FIFO, eventos com o mesmo SystemMetadata.EventGroupId chegam na ordem em que foram publicados. O EventGroupId faz o papel do MessageGroupId da SQS FIFO (ou da key da mensagem, se você vem do Kafka).
A deduplicação acontece no publish, numa janela fixa de 5 minutos, por conteúdo (DeduplicationType=CONTENT_BASED) ou pela sua chave em SystemMetadata.DeduplicationId. Prefira a chave: content-based é cobrada como operação à parte. Duplicata suprimida volta SuccessCode: DEDUPLICATED, e você trata como sucesso.
A AWS chama a combinação de “exactly-once ingestion”. Vou te mandar a real: a palavra que vale ali é ingestão. A dedup cobre o retry do produtor dentro de 5 minutos. O consumidor que caiu depois de gravar e antes de responder, e o replay que você mesmo disparou, ficam por sua conta: idempotência no consumidor continua obrigatória.
No bus compartilhado, o event group pertence à conta que publicou. Duas contas publicando no bus compartilhado com o mesmo EventGroupId formam dois grupos separados, sem ordem entre si e sem dividir vazão. Se o “pedido 123” recebe evento do checkout (conta A) e do pagamento (conta B), o bus não garante que PaymentConfirmed chegue depois de OrderPlaced. Ordem entre times continua sendo problema do seu design: um único publicador por agregado, ou um consumidor que tolera fora de ordem.
Os trade-offs com número: onde o FIFO no bus dói
Head-of-line blocking no grupo
No subscriber FIFO, um evento que falha segura os seguintes do mesmo grupo enquanto é retentado (os outros grupos seguem). A SQS FIFO se comporta igual por message group, então o problema não é exclusivo do bus. Muda quem controla a janela: aqui é a RetryPolicy do subscriber, e a doc resume o dilema, janela de retry longa troca ordem por latência.
Teto de 30 segundos na espera síncrona
Para ordem de verdade com Lambda, a doc manda usar InvocationType REQUEST_RESPONSE; com EVENT, a ordem vale só até a entrega na fila assíncrona da Lambda. O InvocationTimeoutSeconds vai de 1 a 30 segundos, teto fixo. Processamento mais longo que isso não cabe. E Step Functions Standard fica de fora, porque o REQUEST_RESPONSE chama StartSyncExecution, que só state machine Express suporta. Com SQS FIFO no meio, o consumidor puxa no próprio ritmo, com visibility timeout de até 12 horas.
Limite por event group
A ingestão por event group é de 1.500 por segundo, contando o número de eventos mais o tamanho total em KB, e não é ajustável. Pela fórmula, evento de 2 KB consome 3 unidades, o que dá uns 500 eventos por segundo por grupo. Grupo por cliente ou pedido dificilmente chega lá; grupo “global” para forçar ordem total chega rapidinho.
Retry diferente do Classic
O subscriber vem com MaxRetryAttempts 5 e MaxEventAgeInSeconds 300. O target do Classic tinha 185 tentativas e 24 horas. Quem dependia de um dia de retry precisa setar MaxEventAgeInSeconds para 86.400 explicitamente, senão queda de target acima de 5 minutos manda tudo para a DLQ. Sem DLQ, o evento é descartado e a única pista é a métrica EventsDropped. Sem sqs:SendMessage na role, a métrica OnFailureDestinationFailed conta e o evento também se perde. No FIFO, a DLQ tem que ser SQS FIFO.
Dois detalhes quebram handler na migração. Sem BatchConfiguration (ou com MaxBatchSize diferente de 1), a Lambda recebe um array JSON, mesmo com um evento só. Com target SQS FIFO, o SqsParameters.MessageDeduplicationId tem que ser derivado por mensagem com JSONata; valor constante faz a fila descartar tudo depois da primeira.
Não é streaming: onde entram Kinesis e MSK
Retenção, replay e ordem fazem o bus parecer um log. A tese aqui é que ele continua sendo um barramento de integração, agora com memória, e streaming é outro problema. No bus, cada subscriber filtra evento a evento e recebe por push num único target. Em Kinesis Data Streams e Amazon MSK, o consumidor lê por shard ou partition no próprio ritmo, e a conversa é throughput, agregação e janela de tempo com Flink. Telemetria, clickstream e CDC para analytics seguem sendo stream. Para esse lado do mapa, escrevi sobre Kinesis, Firehose, Flink ou MSK.
O que o bus novo disputa é o Kinesis que entrava “no meio” por falta de opção, só para ter ordem e replay entre microsserviços.
E a conta? Por GB contra por evento
O preço mudou de unidade. Na página de pricing (que não diz a qual região os valores se referem): ingress de US$ 0,18 por GB nos primeiros 5.000 GB e US$ 0,12 depois, egress de US$ 0,05 por GB entregue a cada subscriber (retry cobra igual), storage acima da retenção default e evaluation (JSONata, schema validation) a US$ 0,15 por milhão, só quando configurado. Cada evento arredonda para cima no 1 KB. No Classic: US$ 1,00 por milhão de custom events (blocos de 64 KB), entrega na mesma conta de graça e US$ 1,00 por milhão para outro bus.
Bora abrir a conta por milhão de eventos, no primeiro tier, sem evaluation e sem retenção extra. Para acertar a unidade, refiz o exemplo oficial (1.000 eventos por segundo de 2 KB, mês de 30 dias): o ingress bate nos US$ 922 da página usando GB decimal. Então 1 milhão de eventos de S KB são S GB.
Cenário 1, mesma conta, 2 subscribers. Novo: 0,18 × S + 2 × 0,05 × S = 0,28 × S. Classic: US$ 1,00. Com 1 KB o novo sai por US$ 0,28; com 3 KB, US$ 0,84; com 4 KB, US$ 1,12, já acima do Classic.
Cenário 2, cross-account, 1 produtor e 3 contas consumidoras. Classic com bus-to-bus: US$ 1,00 de ingestão mais US$ 1,00 por bus de destino, US$ 4,00 contando só esses itens. Novo: 0,18 × S + 3 × 0,05 × S = 0,33 × S, ou US$ 0,66 com 2 KB. O empate fica perto de 12 KB.
Números ilustrativos: refaça com o seu payload médio e os seus subscribers. O exemplo oficial completo (2 subscriptions, uma com JSONata, schema validation, 7 dias de retenção e 1% de falha com 3 retries) fecha em US$ 2.317 por mês, dos quais US$ 778 são evaluation. Evaluation sozinha é um terço da conta. É Cost Optimization do Well-Architected na prática: medir antes de ligar feature.
Leitor brasileiro: não tem sa-east-1 (por enquanto)
Nem tudo são flores. O lançamento saiu em 14 regiões: N. Virginia, Ohio, Oregon, Irlanda, Frankfurt, Estocolmo, Espanha, Tóquio, Singapura, Sydney, Malásia, Tailândia, Mumbai e Hong Kong. São Paulo ficou de fora, e a doc de sharing diz que o bus e os subscribers do consumidor ficam na mesma região e partição.
Com workload em sa-east-1, adotar o bus novo hoje é publicar cross-region para us-east-1 (ou outra das 14): latência, data transfer cross-region e, se contrato ou política interna exige o dado no Brasil, a discussão de residência. Não achei na doc confirmação de target de subscriber em outra região, então eu planejaria a parte consumidora morando lá também. Quem escolheu São Paulo por requisito segue com Classic e SQS FIFO. E se a ideia é espalhar região para ganhar disponibilidade, vale reler o preço da resiliência multi-região antes de mover o barramento para longe dos consumidores.
Tabela de decisão: Classic, bus novo ou SQS FIFO
| Situação | Classic | Bus novo | SQS FIFO no meio |
|---|---|---|---|
| Workload em sa-east-1 com requisito de região | Sim | Ainda não disponível | Sim |
| Muitas contas, cada time dono do próprio roteamento | Possível, com policy e bus-to-bus | Melhor encaixe (RAM + subscriber por conta) | Uma fila por consumidor, mais peças |
| Ordem por entidade, mesmo publicador | Não tem | FIFO por EventGroupId | Sim, por MessageGroupId |
| Ordem entre contas produtoras diferentes | Não tem | Não garante (grupo é por conta) | Só se todos publicarem na mesma fila |
| Consumidor ordenado que leva mais de 30 s | Não se aplica | Não cabe no REQUEST_RESPONSE | Sim, visibility timeout até 12 h |
| Replay e hidratação de serviço novo | Archive + replay | Nativo, até 365 dias | Sem replay (retenção até 14 dias) |
| Evento de 4 KB ou mais, mesma conta, poucos subscribers | Mais barato | Mais caro por GB | Depende do volume |
| Analytics em alto volume com janela de tempo | Não | Não | Não (aqui é Kinesis ou MSK) |
Então, aposenta? No barramento entre times, numa das 14 regiões, com consumidores rápidos e idempotentes e ordem por entidade dentro de um publicador, eu tiraria a SQS FIFO do meio, sim. O próprio News Blog diz que o modo síncrono dispensa a SQS entre o bus e a Lambda para confiabilidade. Fora desse recorte, a fila merece o lugar dela. E empilhar serviço por simetria tem custo de disponibilidade, como discuti no post sobre multi-cloud e disponibilidade. Não existe bala de prata, existe recorte.
O que você leva
-
O bus novo junta Publish-Subscribe, Durable Subscriber e DLQ por consumidor, com RAM, retenção de 1 a 365 dias e replay por starting position.
-
Ordem é por
EventGroupIde por conta publicadora. Entre times diferentes, o bus não ordena para você. -
O FIFO cobra seu preço: head-of-line blocking durante retry, teto de 30 s no
REQUEST_RESPONSE, Step Functions só Express e 1.500 unidades por segundo por grupo. -
Migrando do Classic? Revise o retry (default de 5 tentativas e 300 s), configure DLQ, use
events:no IAM e ajuste o handler para array. -
Cobrança por GB favorece evento pequeno e muitas contas consumidoras. E sem sa-east-1, quem precisa do dado em São Paulo segue no Classic com SQS FIFO.
E aí, você já está desenhando o barramento novo na sua organização ou vai esperar chegar em São Paulo? Me conta nos comentários, que essa conversa vale levar para o AWS User Group São Paulo. Se o post ajudou, manda aquele joinha, comenta e compartilha para fortalecer, valeu demais!
Fontes
-
What's New: Amazon EventBridge relaunches event buses for enterprise scale (24/09/2026)
-
AWS News Blog: enhanced custom event buses in Amazon EventBridge
BUILD. SCALE. REPEAT. =D